faster-whisper
github.com/SYSTRAN/faster-whisper · 语音 · 开源自建 · 开源免费 · 自建即离线
Whisper 的高效实现:同精度下快数倍、显存占用更低,批量转写的实际选择。
短板:要自己写服务层和队列;GPU 环境配不好会比原版还慢。
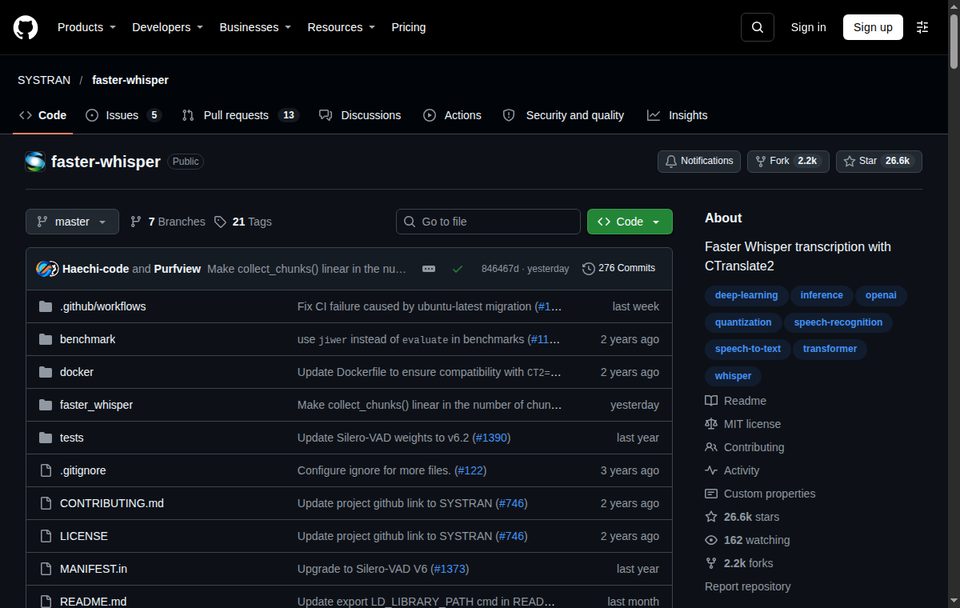
桌面端 · 抓图于 2026-11
配套 skill:批量转写录音,并把错误率测出来
手上一批访谈/会议录音要转文字,要能说清「转得准不准」,而不是转完就交。
可以复制成 batch-transcribe-and-check/SKILL.md 放进 Claude Code,或作为 AGENTS.md 交给 Codex。
- 先用中号模型跑那 3 段样本,人工对比逐句差异,记下错误类型(专有名词/数字/口音/重叠说话)。
- 按错误类型决定要不要上更大模型——如果错的全是人名和缩写,加大模型没用,得加术语表或后处理。
- 批量跑时开 VAD 切分,长音频不要整段喂,否则容易在沉默段产生幻觉文本。
- 输出要带时间戳与说话人分段(如果可以),否则后期的录音没法回查。
- 随机抽 10 段人工校对,把错误率写进交付说明——不写错误率的转写结果等于没验收。
同样用来「语音」的其它选择
- Whisper — 语音转文字的事实标准,中文识别准,本地跑不联网,做会议和访谈转写先看它。
- ElevenLabs — 最像人的语音合成,多语言配音和声音克隆质量在第一档,做有声内容直接可用。
- 通义听悟 — 会议录音转写,自动出摘要、待办和发言人分离,中文会议场景最省事的一个。
← 全部 155 个工具 · 自建选型矩阵 · 痛点专题